Минута на личный кабинет: как мы искали, куда уходит время 1С
Разбор ускорения 1С организации, выдающей займы под залог: личный кабинет в 20 раз быстрее, проверка повторного договора в 50 раз. Замеры и сверка денег.
Началось всё с вопроса клиента. Это финансовая организация, она выдаёт займы под залог. Клиенты смотрят свои договоры в личном кабинете на сайте, и у тех, у кого договоров много, страница грузилась почти минуту. Вторая жалоба пришла из офиса: подготовка документа реализации залогового имущества растягивалась на двадцать с лишним минут.
В базе одновременно работают несколько десятков пользователей, а платежи с сайта идут круглые сутки. Остановить всех и спокойно поэкспериментировать нельзя. Поэтому все замеры, о которых пойдёт речь, мы делали на копии рабочей базы. Сейчас изменения стоят на рабочей.
Сначала смотрим, а не читаем код
Соблазн понятный: открыть конфигурацию, найти «тяжёлые» места и начать их переписывать. Мы так не делаем. Конфигурация большая, и придраться при желании можно к чему угодно. Вопрос в другом: на что сервер на самом деле тратит время.
Мы сняли кэш планов SQL-сервера за 12 рабочих часов и отсортировали запросы по процессорному времени. Картина оказалась не размазанной, а с одним явным пиком. Среди сорока самых тяжёлых запросов на одну группу приходилось около 55 % их общего процессорного времени — 7,38 млн мс за 12 часов. Это запросы «остаток начислений по одному договору». Платежи, расчёт долга, печатные формы — всё ходит через них.
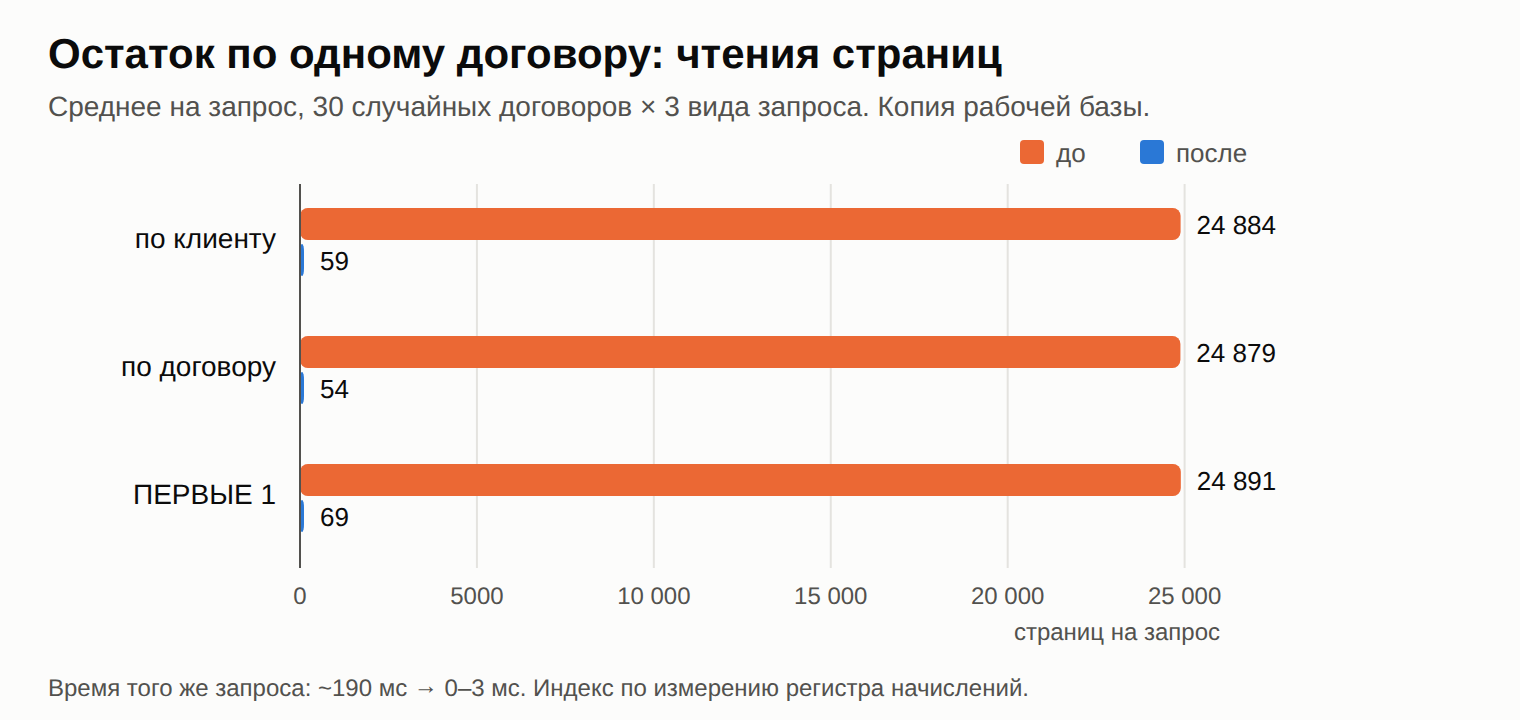
Каждый такой запрос читал около 24 880 страниц данных. Это и насторожило. Мы смотрели запросы с разными договорами, с «ПЕРВЫЕ 1» и без — число чтений почти не менялось. Если серверу всё равно, какой договор вы ищете, он не ищет, а читает таблицу подряд.
Индекс был. Но не тот
Первая мысль — индекса нет. Открыли список индексов: есть. У таблицы итогов регистра начислений (а это больше миллиона строк) индекс ровно один: период, подразделение, договор и дальше.
Дальше всё стало ясно. Запрос передаёт период и договор, а подразделение не передаёт. SQL-сервер проходит по индексу только до первого поля, которое ему не дали, и остаток читает целиком. Представьте телефонный справочник, отсортированный по городу, потом по улице, потом по фамилии. Улицу вы не знаете — значит, будете листать весь город.
Лечится это одним свойством. Измерению «Договор» в конфигураторе мы поставили «Индексировать», и платформа сама построила индекс по договору в таблице движений и в таблице итогов. Можно было создать индекс прямо на SQL-сервере, это быстрее. Но такой индекс тихо исчезнет при первой же реструктуризации базы, и через полгода всё вернётся. Поэтому только через метаданные.
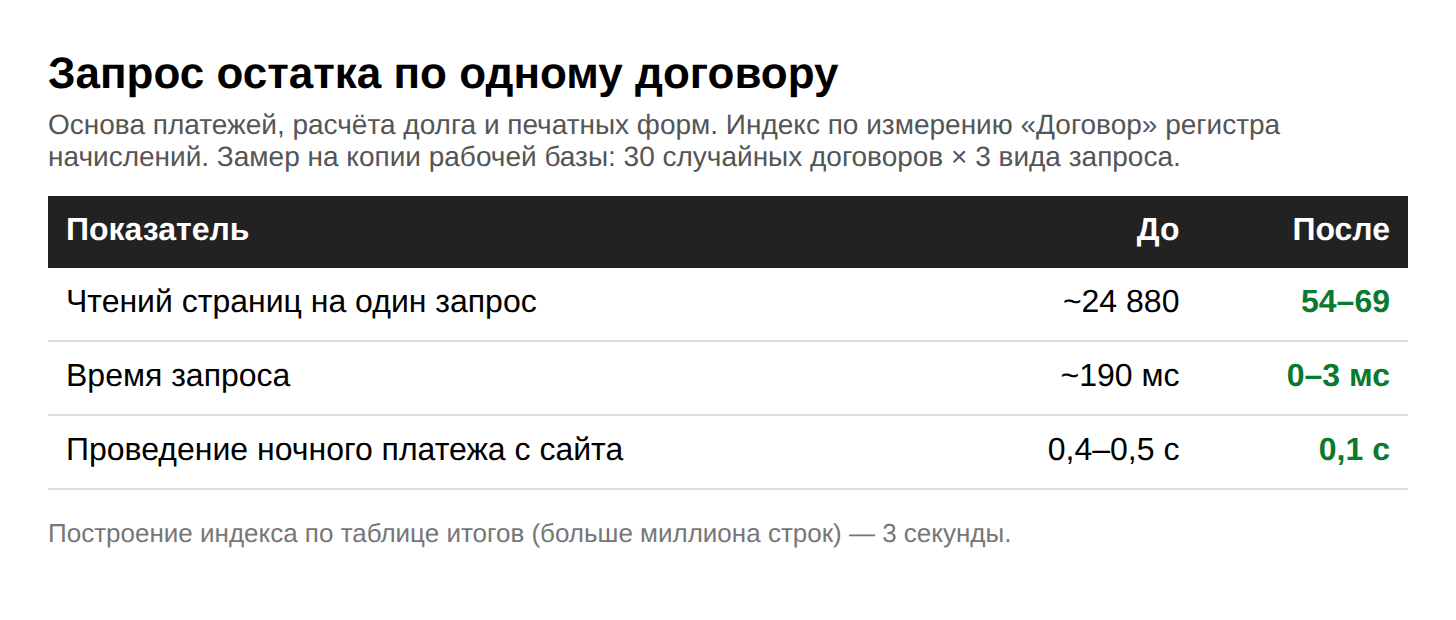
На копии мы взяли 30 случайных договоров и три вида запроса. Чтений стало 54–69 вместо 24 880 — примерно в 400 раз меньше. Время запроса — 0–3 мс вместо ~190 мс. Ночной платёж с сайта проводился 0,4–0,5 с, стал 0,1 с. Сам индекс построился за три секунды.
Через сутки после установки на рабочую базу мы снова посмотрели статистику сервера. Группа «остаток по одному договору» ушла из верхней части списка, новые индексы используются. Нашли и обратную сторону: у другого запроса, списка договоров клиента, чтений стало на 22 % больше. Скорее всего, при реструктуризации пропал наш же старый временный индекс, созданный раньше прямо на SQL, — ровно то, о чём мы предупреждали выше. Время этого запроса не изменилось. Восстанавливать старый индекс мы не стали, а взяли запрос в следующий этап.
Вывод короткий: число чтений, которое не зависит от отбора, почти всегда значит «индекс не тот».
Почему личный кабинет думал минуту
Индекс снял главную нагрузку с сервера, но личный кабинет у клиентов с большим числом договоров всё равно отвечал долго. Мы сняли профиль SQL одного вызова веб-сервиса для клиента со 100 договорами.
Один вызов — 4 489 запросов к базе, 9,3 млн прочитанных страниц и 50 секунд работы SQL. Сервис перебирал договоры в цикле и на каждый делал от 8 до 12 запросов. Но больше всего удивила верхняя строка профиля. Это был не расчёт долга, а поиск договоров по реквизиту «Основной договор» — так связаны договоры после разделения. Индекса по этому реквизиту не было, и каждый поиск читал таблицу из сотен тысяч документов. Две такие строки заняли 32 и 16 секунд из пятидесяти.
Мы пошли в два шага. Сначала поставили «Индексировать» у реквизитов, по которым ищут чаще всего: основной договор, контрагент, договор в операциях, идентификатор платежа сайта. Одно это сократило вызов для клиента со 100 договорами с 36,7 до 4,9 секунды.
Потом убрали сам цикл. Расчёт стал пакетным: список договоров уходит одним запросом, условие по договорам стоит в параметрах виртуальных таблиц, а не в «ГДЕ». Старые процедуры остались, но теперь они вызывают пакетную, чтобы логика расчёта жила в одном месте. Новую ветку веб-сервиса включает отдельная настройка. Если что-то пойдёт не так, её выключают за секунду, без переустановки.
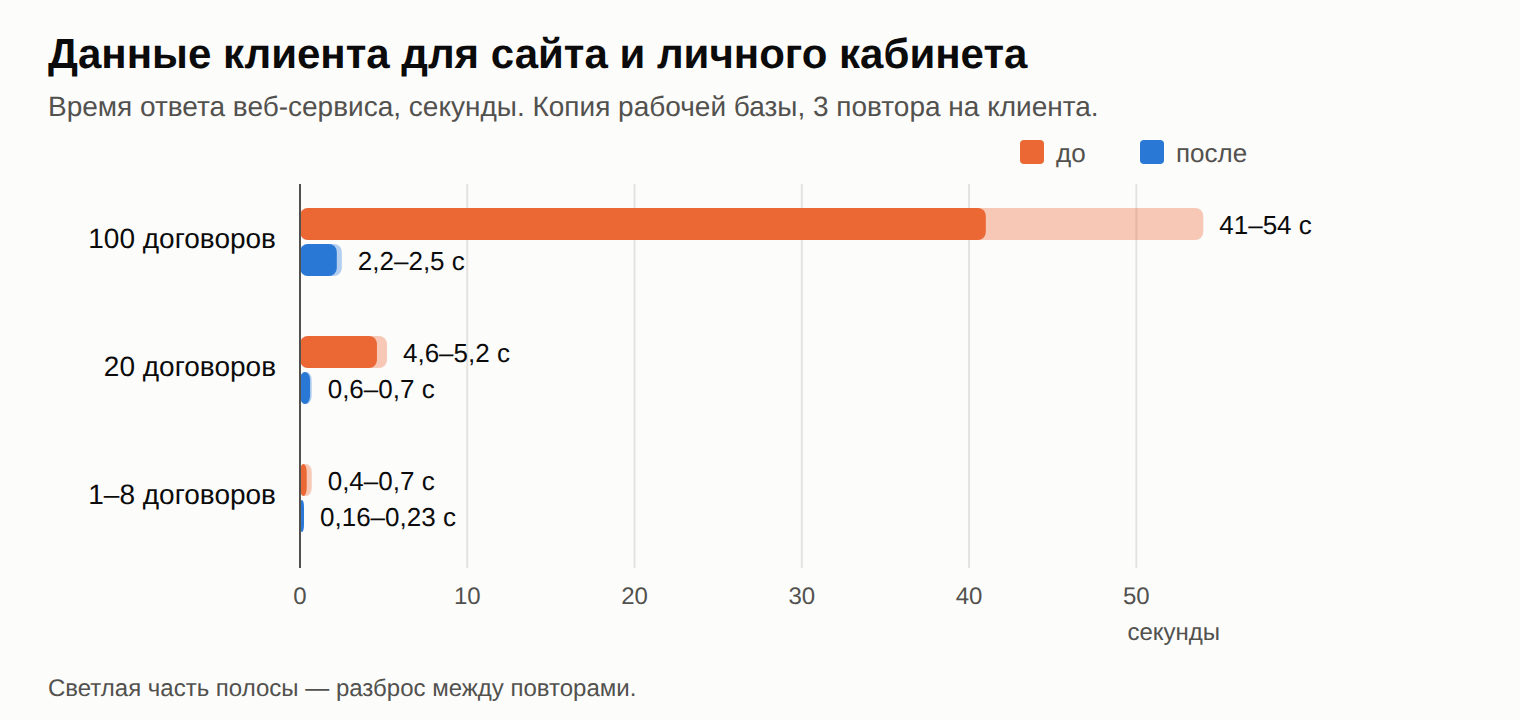
| Сколько договоров у клиента | До | После | Кратность |
|---|---|---|---|
| 100 договоров | 41–54 с | 2,2–2,5 с | ~20 раз |
| 20 договоров | 4,6–5,2 с | 0,6–0,7 с | ~7–8 раз |
| 1–8 договоров | 0,4–0,7 с | 0,16–0,23 с | 2–3 раза |
Обратите внимание на нижнюю строку. У клиента с одним-двумя договорами всё и раньше работало сносно, выигрыш там скромный. Проблема была не в одном медленном запросе, а в том, что быстрый запрос повторяли сотни раз.
Проверка, которая смотрела на всю базу ради одной записи
Похожая история нашлась там, где её никто не ждал, — при записи договора. Конфигурация проверяет, не является ли новый договор повторным, то есть перекредитованием по уже существующему. Для этого она брала срез последних статусов по всему регистру — по сотням тысяч договоров — и только потом отбрасывала лишнее условием в «ГДЕ».
Это частая ошибка, о которой прямо пишут в рекомендациях 1С: условие на отбор нужно передавать в параметры виртуальной таблицы, тогда сервер сразу берёт нужные строки. Мы перенесли условие, и проверка стала занимать 0,02 с вместо 1,07 с, примерно в 50 раз быстрее. Результат сравнили на 600 договорах, больше двух третей из них — повторные. Расхождений нет.
Заодно ускорились короткие поиски по реквизитам, которые выполняются при выдаче займа, при оплате и в журналах. Поиск договоров клиента занимал 0,17 с, операций по договору — 0,08 с, проверка повторной оплаты с сайта — 0,18 с, поиск связанных договоров — 0,16 с. После индексов каждый из них — около 0,002 с, в 40–90 раз быстрее. По отдельности это доли секунды. Но таких вызовов тысячи в день.
Как правило из учебника сделало хуже
Самое поучительное случилось с журналом операций по договорам. Это динамический список, за всё время в нём больше миллиона строк.
Первую версию правки мы сделали «по учебнику». Подзапрос отправили в параметры среза. Отбор по дням просрочки переписали с функции РАЗНОСТЬДАТ на границы дат, как обычно советуют. Запустили замер и не поверили цифрам. Запрос с подзапросом в параметрах на этих данных выполнялся 430,7 с против 1,7 с. Отбор «просрочка от одного дня» за всё время — 37–40 с вместо прежних 3,7–5,1 с. В десять раз хуже.
Обе правки мы откатили ещё до выкатки. Оставили только то, что на замере дало выигрыш. Ориентиром был стандарт 1С «Запросы в динамических списках», но решал замер, а не уверенность в правиле. Набор строк и колонок мы сверили со старым журналом: все 18 колонок совпали на выборках от сотен до десятков тысяч строк.
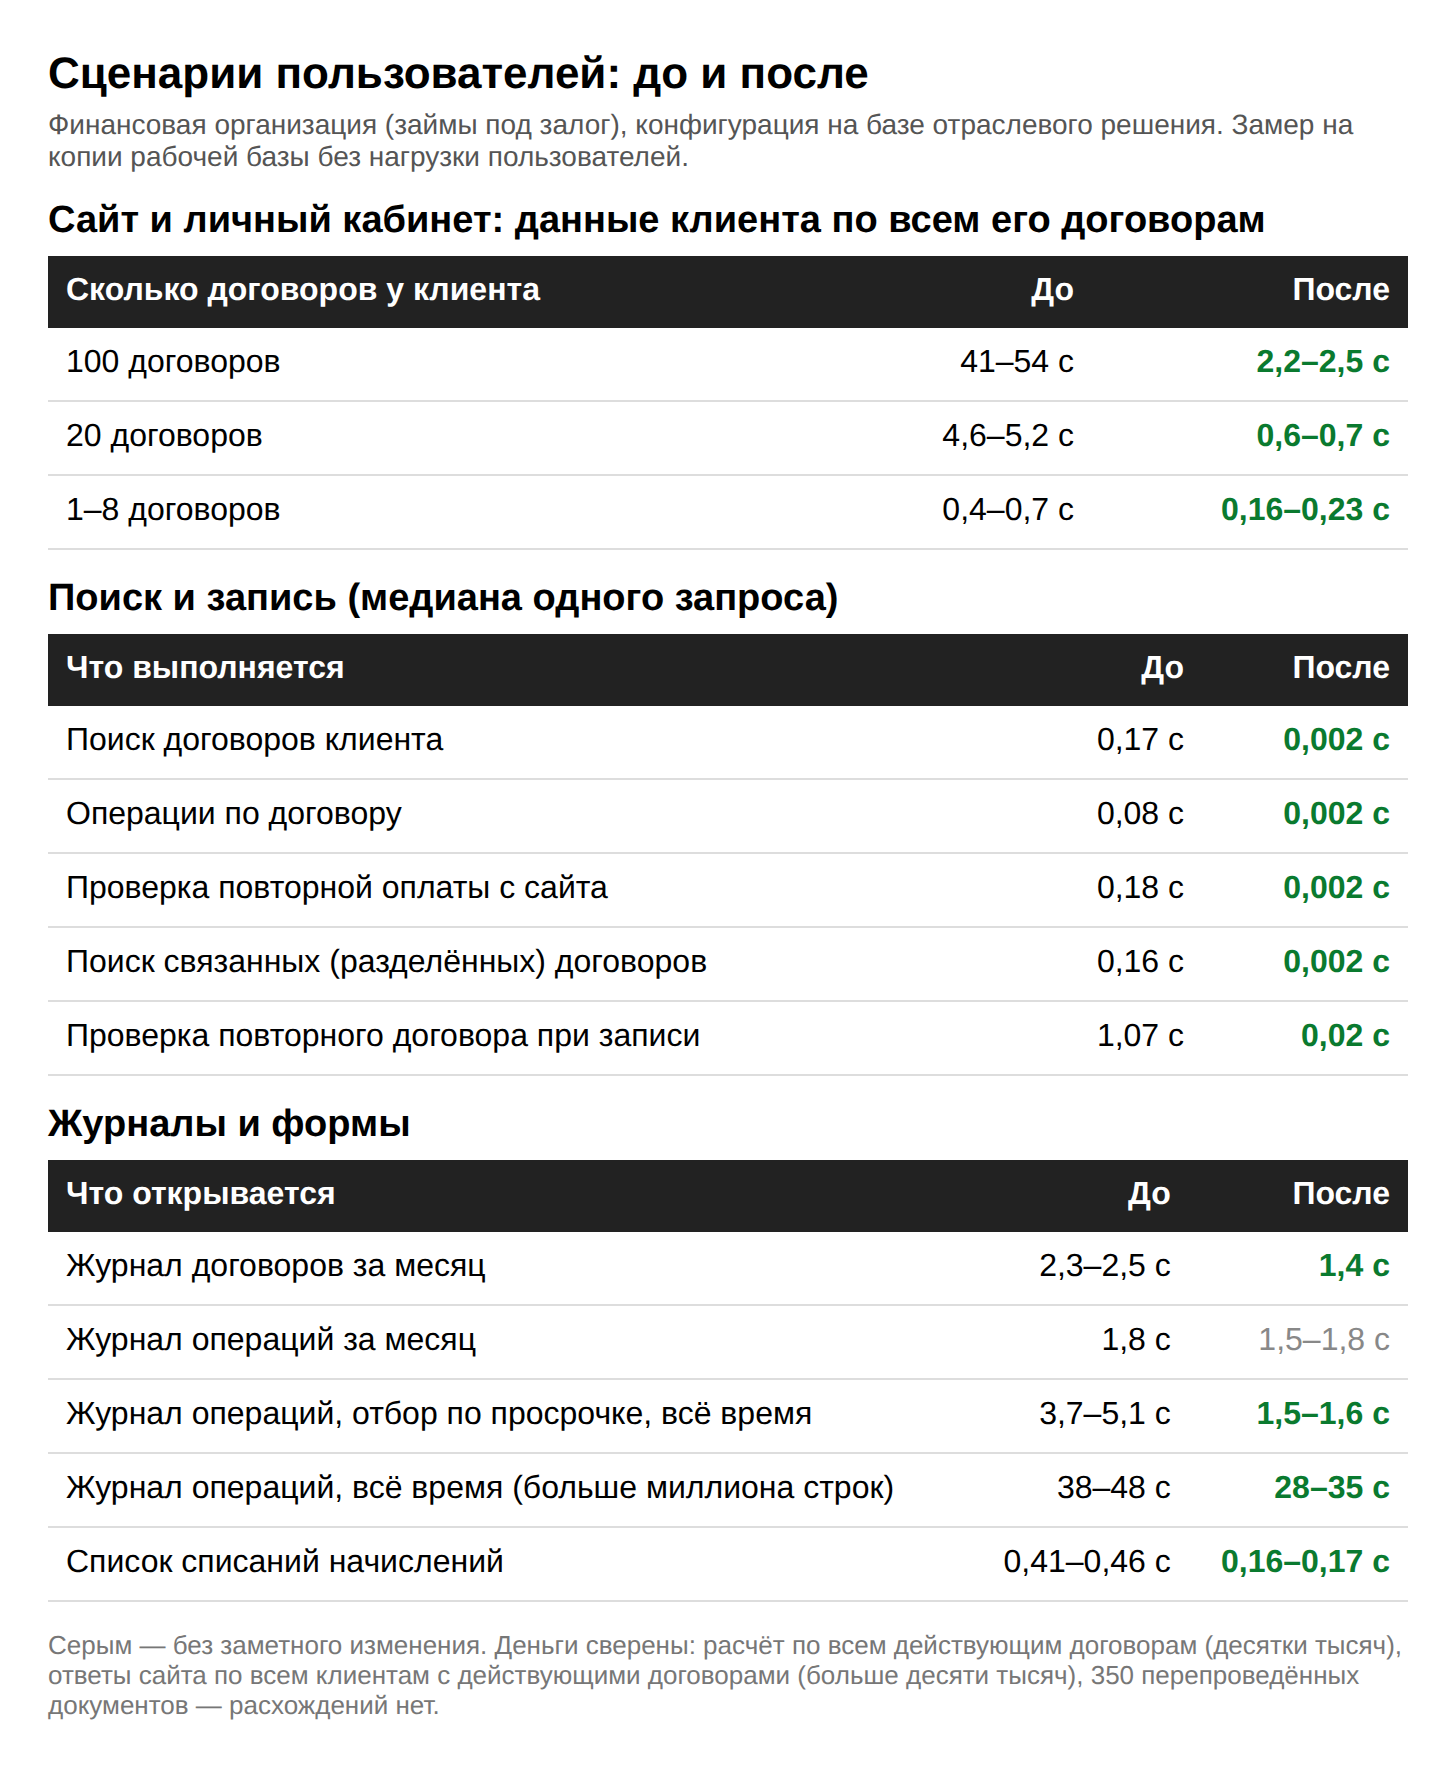
В итоге журнал договоров за месяц открывается за 1,4 с вместо 2,3–2,5 с. Журнал операций с отбором по просрочке за всё время — 1,5–1,6 с вместо 3,7–5,1 с, без отбора — 28–35 с вместо 38–48 с. Журнал операций за месяц почти не изменился: 1,5–1,8 с против 1,8 с. Список списаний начислений — 0,16–0,17 с вместо 0,41–0,46 с.
Урок, который мы запомнили: правило без замера — это гипотеза.
Восемьдесят шесть записей одного документа
Отдельная жалоба касалась реализации залогового имущества. Подготовка одного документа занимала больше двадцати минут. Мы открыли журнал регистрации и сначала решили, что тормозит проведение. Оказалось, нет: до проведения документ был полностью перезаписан 86 раз.
Причина нашлась в форме. Она вызывала «Записать()» непроведённого документа на каждом переходе по строке партии, при подборе и при исключении имущества. А каждая запись переписывала восемь табличных частей, больше десяти тысяч строк. Само проведение было пакетным, на него уходили секунды. Минуты съедали эти бесконечные записи.
Мы убрали запись из обработки строк. Состав партии теперь берётся из данных формы, документ записывается один раз, пересчитывается только изменённая партия. Всё сделано в отдельном расширении, основную конфигурацию не трогали.
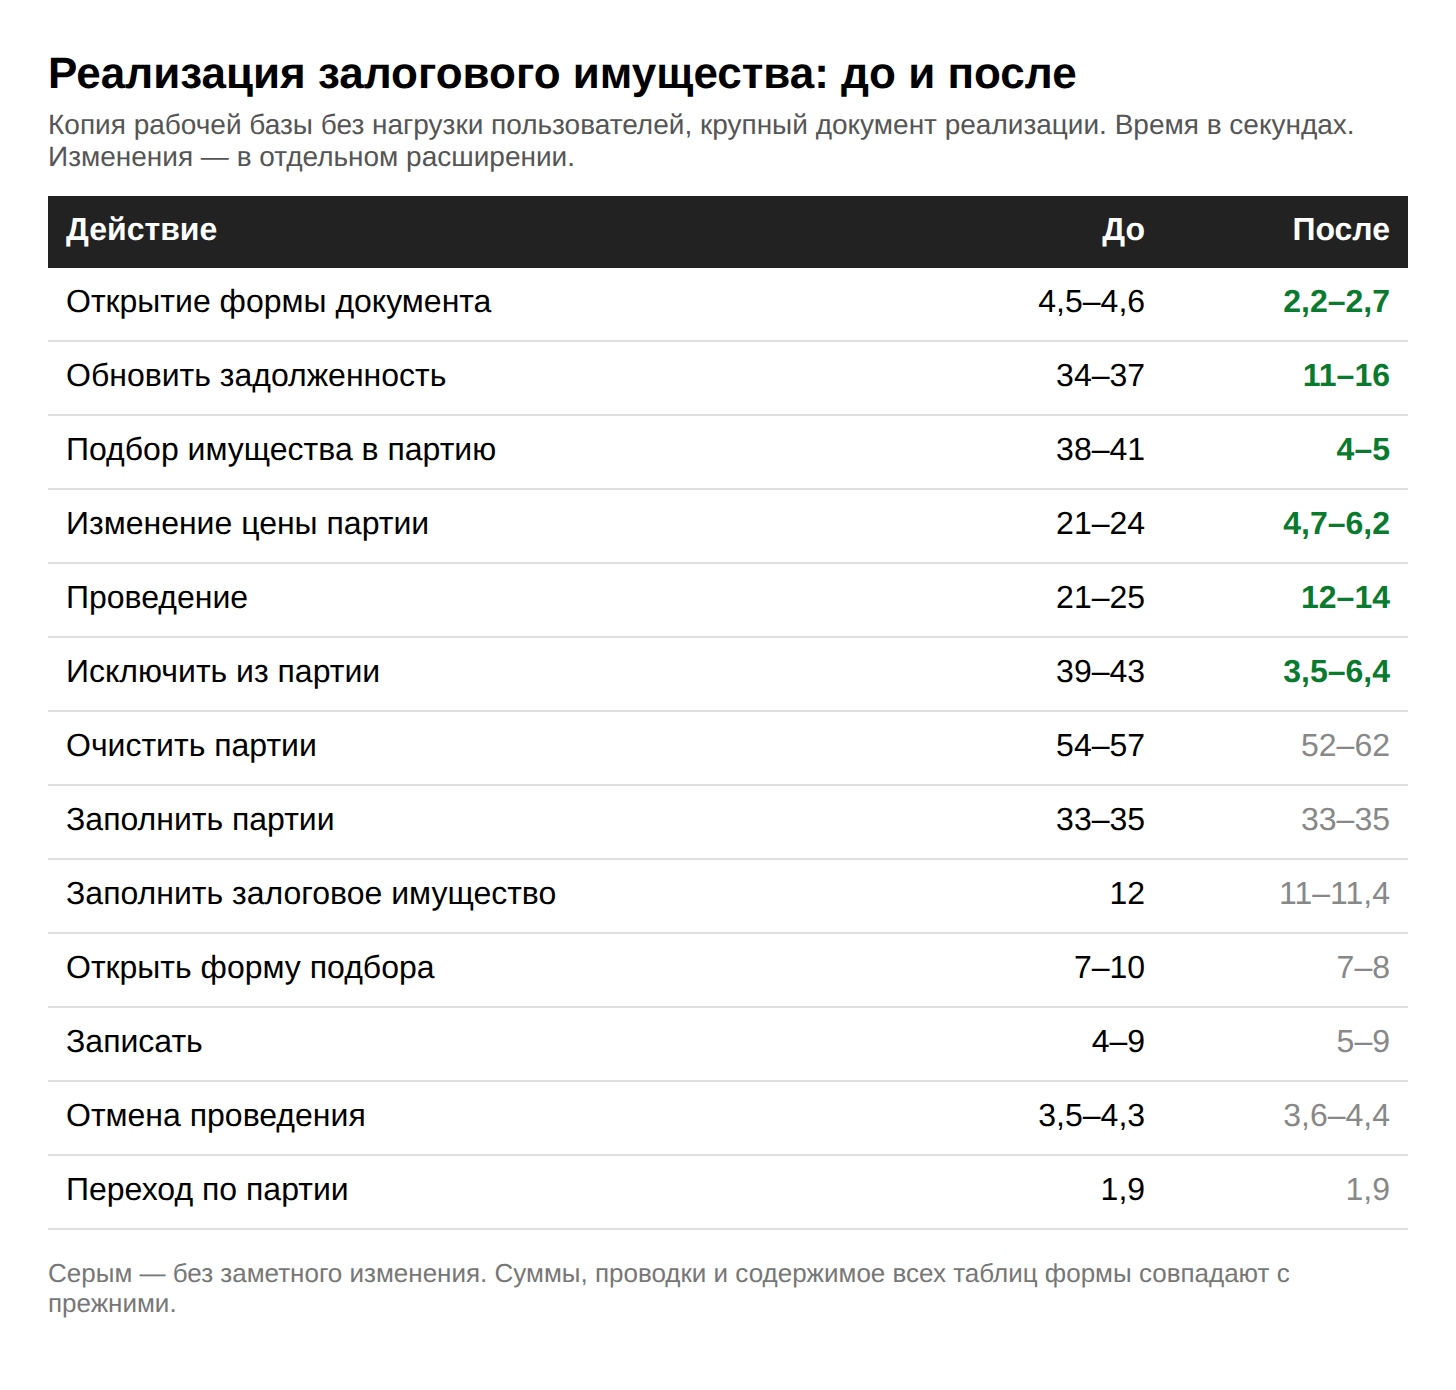
Подбор имущества в партию стал занимать 4–5 с вместо 38–41 с, исключение из партии — 3,5–6,4 с вместо 39–43 с. «Обновить задолженность» — 11–16 с вместо 34–37 с, проведение — 12–14 с вместо 21–25 с. Часть команд не ускорилась: «Заполнить партии» как занимало 33–35 с, так и занимает. В таблице такие строки серые, мы их не прячем.
Деньги должны сойтись до тиына
Для финансовой организации ускорение ничего не стоит, если изменился хоть один расчёт. Поэтому десяток примеров нас не устраивал — проверяли на полной выборке.
Мы посчитали старым и новым кодом данные и задолженность по дням для всех действующих договоров, а это десятки тысяч. Сравнили ответы сайта старого и нового веб-сервиса для всех клиентов с действующими договорами, а их больше десяти тысяч. Перепровели 350 документов: операции по договорам, закрытия дня, списания. Расхождений ноль.
Потом проверили саму проверку. В тестовой копии мы намеренно испортили расчёт — сверка сразу показала расхождения. Сверка, которая не может упасть, ничего не проверяет.
Как ставили на рабочую базу
Ставили ночью, в окно, когда с сайта не идут платежи. Это окно мы тоже нашли по замеру, а не на глаз. Порядок полностью автоматический: полная резервная копия с проверкой, сверка объектов рабочей базы с эталоном, точка отката, загрузка, автоматические проверки. Если кто-то успел поменять конфигурацию после нашей сверки, выкатка сама останавливается. При любой ошибке изменения откатываются, и вход открывается.
Что мы вынесли
Больше половины нагрузки на сервер давал один запрос. По коду мы бы его не нашли: он выглядел безобидно, проблема была в индексе. Начинать нужно со статистики сервера.
Индекс ставим только через метаданные. Самодельный индекс на SQL живёт до первой реструктуризации.
Цикл с запросом внутри — первый подозреваемый. Индексы вместе с пакетным запросом дали около двадцати раз там, где ускорение одиночного запроса не дало бы почти ничего.
Правила 1С по запросам почти всегда верны. «Почти» мы видели своими глазами: 430 секунд вместо 1,7.
И деньги проверяем на полной выборке, а потом проверяем саму проверку.
Если у вас 1С на отраслевой или доработанной конфигурации и отдельные операции «думают» десятки секунд — напишите нам, это часть нашей работы по сопровождению 1С. Мы начнём с замера и покажем, куда уходит время, прежде чем что-то менять.
Все цифры — замеры на копии рабочей базы до и после изменений; клиент обезличен, масштабы данных указаны округлённо.
Автор материала: Саттаров Шахрух.